
Μπορεί η Τεχνητή Νοημοσύνη να ακούσει και να κατανοήσει μια γλώσσα που δεν διαθέτει αρκετά ψηφιακά δεδομένα; Το ερώτημα αποκτά ιδιαίτερη σημασία για τη Ρομανί, την Τσακωνική, την Καππαδοκική, την Ποντιακή και τα Αρβανίτικα, πέντε ελληνικές γλωσσικές ποικιλίες που περνούν από την προφορική παράδοση και τα αρχεία στον κόσμο της νέας τεχνολογίας.
Τα πέντε έργα για τη διάσωσή τους εντάσσονται στην πρωτοβουλία LINGUA της Microsoft, η οποία στηρίζει γλώσσες και διαλέκτους με μικρό ψηφιακό αποτύπωμα. Πρόκειται για τον μεγαλύτερο αριθμό ελληνικών έργων μεταξύ των συμμετεχουσών ευρωπαϊκών χωρών, σύμφωνα με ανακοίνωση της Microsoft.
Η πρόκληση αφορά χιλιάδες γλώσσες σε όλο τον κόσμο. Από τις περίπου 7.000 γλώσσες που ομιλούνται σήμερα, οι περισσότερες έχουν περιορισμένη παρουσία στο διαδίκτυο και, ως εκ τούτου, δεν διαθέτουν το απαραίτητο υλικό για την υποστήριξή τους από τα ψηφιακά εργαλεία που χρησιμοποιούνται καθημερινά.
Όταν μια γλώσσα δεν καταγράφεται, δεν ψηφιοποιείται και δεν εντάσσεται σε γλωσσικά σώματα, κινδυνεύει να μείνει εκτός των δεδομένων με τα οποία εκπαιδεύονται τα συστήματα Τεχνητής Νοημοσύνης. Και όσο η επικοινωνία, η γνώση και οι υπηρεσίες μεταφέρονται σε ψηφιακά περιβάλλοντα, τόσο η απουσία αυτή μπορεί να περιορίσει τη δυνατότητα των ομιλητών να τα χρησιμοποιούν στη γλώσσα τους.
Αυτό είναι το νέο πεδίο γλωσσικής ανισότητας στην εποχή της Τεχνητής Νοημοσύνης. Για τις πιο διαδεδομένες γλώσσες, η πρόσβαση σε σχετικά εργαλεία θεωρείται σχεδόν αυτονόητη. Για πολλές μικρότερες, όμως, η έλλειψη δεδομένων δημιουργεί σημαντικά εμπόδια.
Στην Ελλάδα, το ζήτημα συνδέεται με μια πλούσια και σύνθετη γλωσσική κληρονομιά. Η Ρομανί, η Τσακωνική, η Καππαδοκική, η Ποντιακή και τα Αρβανίτικα έχουν διαφορετική ιστορία, δική τους ταυτότητα και ζωντανή ή καταγεγραμμένη παράδοση. Δεν αποτελούν μια ενιαία κατηγορία, καθώς οι όροι «γλώσσα» και «διάλεκτος» δεν περιγράφουν πάντοτε με τον ίδιο τρόπο τις συγκεκριμένες ποικιλίες. Κοινό τους στοιχείο είναι το πολύ μικρότερο ψηφιακό αποτύπωμά τους σε σχέση με την κοινή νεοελληνική και τις μεγάλες διεθνείς γλώσσες.
Η ΑΡΣΙΣ – Κοινωνική Οργάνωση Υποστήριξης Νέων έλαβε χρηματοδότηση 50.000 ευρώ για την ψηφιοποίηση γλωσσικού υλικού της Ρομανί. Παράλληλα, τέσσερις ακόμη πρωτοβουλίες υποστηρίζονται με πιστώσεις Azure και πρόσβαση στην τεχνογνωσία του AI for Good Lab της Microsoft.
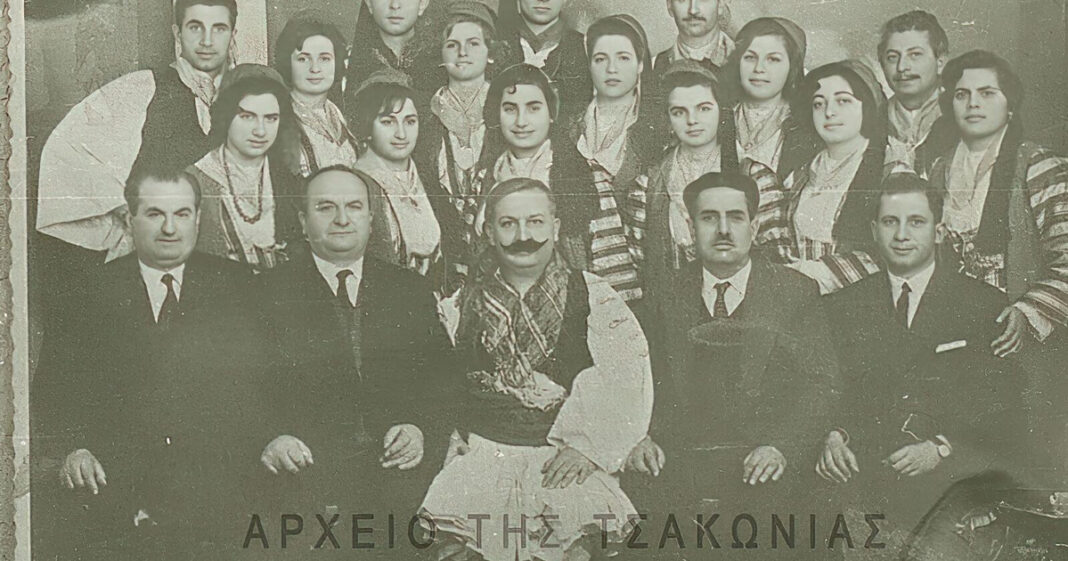
Πρόκειται για το CoDAG του Πανεπιστημίου Κρήτης, το LALIES του Ινστιτούτου Επεξεργασίας του Λόγου του Ερευνητικού Κέντρου «Αθηνά», το T.S.A.K.O.N.I.A. του Αρχείου της Τσακωνιάς και το Istorima.
Η αξία αυτών των δράσεων δεν περιορίζεται στην αποθήκευση παλιού υλικού σε ψηφιακή μορφή. Η καταγραφή του προφορικού λόγου, η ψηφιοποίηση των αρχείων και η δημιουργία γλωσσικών σωμάτων μπορούν να αποτελέσουν το πρώτο βήμα, ώστε οι συγκεκριμένες γλωσσικές ποικιλίες να γίνουν αναζητήσιμες και αξιοποιήσιμες σε νέες εφαρμογές.
Για γλώσσες και διαλέκτους που μεταδίδονται κυρίως μέσα από την καθημερινή ομιλία, την οικογένεια και τη βιωμένη εμπειρία, η διαδικασία αυτή έχει ακόμη μία διάσταση. Διασώζει λέξεις, εκφράσεις και τρόπους αφήγησης που ενδέχεται να μην έχουν αποτυπωθεί επαρκώς σε γραπτές πηγές.
Ωστόσο, η Τεχνητή Νοημοσύνη δεν μπορεί να «μάθει» μια γλώσσα χωρίς το κατάλληλο υλικό. Όπως εξηγεί ο Wassim Hamidouche, Principal Research Scientist στο AI for Good Lab της Microsoft, η περιορισμένη διαθεσιμότητα γλωσσικών δεδομένων επηρεάζει την αποτελεσματικότητα των σχετικών εργαλείων και μπορεί να περιορίσει την ισότιμη πρόσβαση των ομιλητών στην τεχνολογία, την εκπαίδευση και τις νέες ευκαιρίες.
Η διατήρηση των διαλέκτων, επομένως, ξεπερνά τα όρια της πολιτιστικής καταγραφής. Αν οι μελλοντικές ψηφιακές υπηρεσίες λειτουργούν κυρίως στις γλώσσες που διαθέτουν μεγάλο όγκο δεδομένων, οι ομιλητές μικρότερων γλωσσικών κοινοτήτων θα χρειάζεται να προσαρμόζονται σε ένα περιβάλλον που δεν τους αναγνωρίζει γλωσσικά.
Η ενίσχυση του διαθέσιμου υλικού μπορεί να διευρύνει τις δυνατότητες αξιοποίησης των τεχνολογιών, χωρίς αυτό να σημαίνει ότι λύνει από μόνη της όλα τα ζητήματα γλωσσικής εκπροσώπησης.
«Η γλώσσα μεταφέρει την ιστορία, τις αξίες και την ταυτότητα των ανθρώπων. Όταν μια γλώσσα δεν έχει ψηφιακή παρουσία, κινδυνεύει να χαθεί μαζί με ένα σημαντικό κομμάτι του πολιτισμού που εκπροσωπεί», σημειώνει η Γιάννα Ανδρονοπούλου, CEO της Microsoft Ελλάδας, Κύπρου, Μάλτας και Αδριατικής και προσθέτει: «Και αφού μάθαμε την τεχνητή νοημοσύνη να μιλά, τώρα ήρθε η ώρα να της μάθουμε να ακούει όλες τις φωνές».
Το LINGUA υλοποιείται στο πλαίσιο των ευρύτερων European Digital Commitments της Microsoft, με στόχο να ενισχυθεί η ψηφιακή παρουσία γλωσσών με περιορισμένο διαθέσιμο περιεχόμενο και να υποστηριχθεί η γλωσσική και πολιτιστική πολυμορφία της Ευρώπης. Για την Ελλάδα, το στοίχημα είναι αν η Ρομανί, η Τσακωνική, η Καππαδοκική, η Ποντιακή και τα Αρβανίτικα θα καταφέρουν να αποκτήσουν θέση σε έναν κόσμο όπου οι μηχανές ακούν και απαντούν — και αν η τεχνολογία θα μπορέσει να αναγνωρίσει τις φωνές που μέχρι σήμερα έμεναν στο περιθώριο των δεδομένων.